ブログ

なぜAIを含むデジタル公共財はオープンデータに依存すべきなのか

by Cable Green, Creative Commons
2025年1月27日

クリエイティブ・コモンズ(CC)は、(道徳的、倫理的、プライバシーの観点から)共有すべきでないデータや、(法的、その他の理由から)共有できないデータもあることを認識した上で、知識の生産を促進するためにオープンデータの作成、共有、利用を奨励することに価値があると考えています。オープンコミュニティが教育、科学、文化のためのデジタル公共財や公共のインフラサービスを想像し、設計し、構築し続ける中で、これらの財やサービスは、可能かつ適切な場合はいつでも、オープンデータを作成し、共有し、そしてそれを基に構築されるべきです。

Open Data by Auregann is licensed under CC BY-SA 3.0.

オープンデータとデジタル公共財(DPG)

CCはデジタル公共財アライアンス(DPGA)のメンバーであり、CCの法的ツールはデジタル公共財(DPG)として認められています。DPGとは、「オープンソースソフトウェア、オープンスタンダード、オープンデータ、オープンAIシステム、オープンコンテンツコレクションのうち、プライバシーやその他の適用可能なベストプラクティスを遵守し、害を及ぼさず、国連の2030年持続可能な開発目標(SDGs)の達成に高い関連性を持つもの」と定義されています。世界最大級の課題を解決したいのであれば、政府や他の資金提供者はDPGに投資し、開発し、オープンライセンスで提供し、共有し、活用する必要があります。

データは経済の活力を生み出す主要な要素であり、公共の利益に貢献するポテンシャルを持つことが実証されていることから、オープンデータはDPGにとって重要です。公共部門においては、データは政策立案や公共サービスに情報を提供することで、限られた資源を最も必要としている人々に分配するのに役立ちます。また、政府の説明責任を追及する手段を提供し、社会イノベーションを促進します。つまり、データは人々の生活を向上させる可能性を秘めているのです。データが閉鎖されていたり何かしらの理由で利用できない場合、一般の人々はこのような恩恵を受けることができません。

CCは最近、DPG標準の一部としてオープンデータの整合性を維持するために活動しているDPGAの小委員会の一員として活動しました。DPG標準に対するこの重要なアップデートは、オープンライセンスを持つオープンデータセットおよびコンテンツコレクションのみがDPGとして認められることを保証するために導入されました。この新しい要件は、オープンデータセットとコンテンツコレクションがデジタル公共財として認められるためには、以下の基準を満たす必要があることを意味します。

  1. 包括的なオープンライセンス:
    データセット/コンテンツコレクション全体が、適切なオープンライセンスのもとにあること。複数のライセンスが混在するコレクション(ミックスライセンス)は今後認められません。
  2. アクセス可能で発見しやすいこと:
    すべてのデータセットおよびコンテンツコレクションのDPGはオープンライセンスのもとで提供され、一意のURLなど明確で一元化された場所から容易にアクセスできること。
  3. 許容されるアクセス制限:
    ユーザーを差別したり、地理やその他の要因に基づいて使用を制限したりしない限り、ログイン、登録、APIキー、スロットリングなどの一定のアクセス制限は許可されます。

DPGAは次のように述べています。

「この新しい要件は、ユーザーが知的財産権の侵害を懸念することなく安心してソリューションを活用できるようにすることで、すべてのDPGに対する信頼と信用が高まるように設計されています。アクセスと利用を簡素化することは、DPGを真にオープンで利用しやすくし、広く普及させるというDPGAの目標に沿うものです。…それは法的不確実性のない、イノベーションが繁栄できる環境とエコシステムの育成に役立ちます。」

AIとオープンデータ

AIと、AIが世界的な課題の解決に役立つ公共財となる可能性についてCCが検討している中で、オープンデータも同様に重要な役割を果たすと考えています。

CCは、AIが急速に発展している分野であることを認識しており、AIに関する定義、推奨事項、ガイダンス、警告を作成するための皆さんの熱心な取り組みに感謝しています。コミュニティによる2年間の協議の後、オープンソース・イニシアティブ(OSI)は2024年10月28日にオープンソースAIの定義(OSAID)のバージョン1.0をリリースしました。この定義は、AIシステムにとってオープンとは何かについて議論を始めるための重要な一歩です。しかしOSAIDのデータ共有の要件は、特にAIモデルのための学習データを共有すべきかどうか、またどのように共有すべきかについては依然として議論の余地があります。

CCは、オープンデータセットの構築と公開が難しいからといって、それを奨励すべきでないということにはならないと考えています。学習データを共有すべきでない、あるいは共有できない場合には、そのデータはクローズドと定義し、データセットの内容を説明する詳細な要約と再現性のための指示を提供することを推奨します。データをオープンな形で共有できる場合には、そうすべきです。

私たちはDPGAのCEOである Liv Marte Nordhaug 氏が最近投稿した下記の言葉に賛同します。

 「AIシステムに関しては、他のカテゴリーのDPGよりも寛容なAIシステムへのアプローチを進めることで、オープンデータ運動やDPGのカテゴリーとしてのオープンデータを不用意に損うことがないようにする必要があります。学習データに関する高い基準を維持すると、DPG標準の基準を満たすAIシステムの数を減らす可能性があります。しかし、SDGsとの関連性、プラットフォームからの独立性、「害を与えない」ことを設計に組み込むことは、DPGを他のオープンソース・ソリューションとは一線を画す特徴であり、そうした理由から、(AIの)学習データを含めることが必要なのです。」

今後の取り組み

CCは、AIモデルがデジタル公共財として認められるための基準を策定するにあたり、DPGAやその他のパートナーと協力し続けます。この分野において、私たちはオープンデータセットを推進し、AIモデルのすべてのコンポーネントをオープンな形で公開しなくても、各コンポーネントがデジタル公共財として認められるような階層型アプローチの検討を提唱していきます。この度更新された推奨事項とガイドラインは、オープンデータセットを利用・共有し、完全にオープンなAIシステムの価値を認識するもので、それらはAIが公共の利益に貢献することを保証する上で重要な役割を果たすでしょう。

参考資料


このブログ投稿は Cable Green と Creative Commons による “Why Digital Public Goods, including AI, Should Depend on Open Data” を翻訳したものです。

(担当:豊倉)

CCJP年次報告書(2023年度分)のお知らせ

クリエイティブ・コモンズ・ジャパン(CCJP)の主に2023年度の活動、注目している動向などを年次報告書としてとりまとめましたのでここに公開いたします。

2024年8月16日に最近一年ほどのCCJPやグローバルのCCの活動を紹介すると共に、AIとデジタルアーカイブなど複数分野に横断的に存在する来歴情報などのニーズについて議論するイベントを開催しました。このイベントの主なスライド資料を元に、CCJP年次報告書として公表させていただきます。末尾にはCCJPの母体であるNPO法人コモンスフィアの会計報告なども記載しています。ぜひ一度ご覧いただけたら幸いです。
報告書: オンラインスライド版 (Google Slides), PDF版

8/16(金) AI、DA分野の著作権に似た制度課題検討とCCJP年次報告会2024 開催のお知らせ

クリエイティブ・コモンズ・ジャパン(CCJP)では、最近一年ほどのCCJPやグローバルのCCの活動を紹介すると共に、生成AIやデジタル・アーカイブの領域を横断するような話題を議論するイベントを開催します。

このイベントでは年次報告会として私たちCCJPが普段どのような活動をしており、グローバルのCCではどのような動きがあるかをお伝えするとともに、オープン化にまつわる近年のトピックをひとつとりあげて「特集」的に議論いたします。

今年のイベントでとりあげるトピックはデジタル・アーカイブや生成AIにおいて、著作権制度に類似しつつも、制度外で扱われるかもしれない課題です。例えば次のような事象からそれらが伺えます。

・デジタル・アーカイブの運営者が、パブリックドメインの資料について、CCライセンスの下にアーカイブ資料を提供する場合があること
・AIの学習データとして自分の著作物が利用されることについて許諾したり、拒否したり、何らかの条件を課したいと考え、CCライセンスが使われることがあること
・様々な由来・来歴情報のニーズがあり、虚構と現実の記録、AI生成物と創作物、などを区別しやすくすることや、AIの学習に使われたデータの概要を示すことなどが求められるようになってきていること

これらの多くに共通するのは著作者・著作権者以外の関係者、著作権法上には規定のない出典などについてのいわば「メタデータ」の扱いですが、そのような情報の表示義務以外にも、利用・使用に関する制約の意向なども存在しています。こうした課題の種類や広がりについて検討し、また、解決方法として法的、技術的、社会的ものが議論され、あるいは導入されてきていることからこれらをとりあげて議論します。

クリエイティブ・コモンズ・ジャパンがこれまでとりあげてきたイベントのテーマの中でも今回のテーマは整理が難しく、ややわかりにくい、公開での勉強会といった性質の議論になる可能性があることをご承知おきください。また、関係がある動向や解決策についてご存じの方からの情報提供なども歓迎いたします。

【開催概要】
「AI、DA分野の著作権に似た制度課題検討とCCJP年次報告会2024」
日時:8月16日 (金) 18:30-20:30
参加料:無料
開催形式:オンライン(Webex)(※今回はオフラインの会場はありません)
お申し込み:(お申し込み受付は終了いたしました。)

【プログラム(暫定版)】
※当日までに変更になる可能性があることをご了承ください。
18:30-18:35 開会/主旨説明
18:35-19:00 CCJP国内の活動報告、クリエイティブ・コモンズのグローバルの動向・活動などの報告
19:00-20:27 特集セッション:AI、DA分野の著作権に似た制度課題の検討
20:27-20:30 閉会挨拶 

お問合せ・ご連絡先:
お申し込み期限後のキャンセルなどのご連絡は info at creativecommons.jp までメールでのご連絡をお願いします。( at は@マークに変換してください)

パブリックドメインの資料を利用する際に所蔵機関について言及することを利用者に促すには

本記事のPDF版はこちら

Ocean Coast by Maurice Denis、パブリック・ドメイン・マーク、スウェーデン国立美術館

はじめに

本ガイドラインは、デジタル化されたパブリックドメインの文化遺産資料の利用に関して、それを所蔵する文化遺産所蔵機関が自身への言及を利用者に促したい場合のデザイン上のアイディアと実施例を提供するものです。本ガイドラインはパブリックドメイン資料をオープンに共有する所蔵機関を対象としていますが、文化遺産の電子資料に関連する著作権ライセンス問題に関心のあるすべての人にとって有益であると考えます。

背景

オープンカルチャーの広まり

文化遺産所蔵機関は、所蔵する資料を保存し共有することで、地域社会にとって欠かすことのできない役割を担っています。そしてインターネットとそれに伴うデジタル革命によって、所蔵機関が相次いで収蔵品をオンラインで公開し始めました。つまり、著作権の制約がない、またはほとんどない状態で、無料でアクセス、利用、再利用できるように広く公開されるようになったのです。クリエイティブ・コモンズの「Open Culture Voices」シリーズで多くの専門家が述べているように、オープン化は地域社会や一般市民に対して計り知れないほどの恩恵をもたらします。クリエイティブ・コモンズ(CC)ライセンスとパブリック・ドメイン・ツールは、「オープン」を実現するための重要な要素です。

パブリックドメイン作品のデジタル複製を公開するときに使えるCCライセンスはない

デジタル化され、オンラインで利用できるようになった多くの文化遺産は、著作権の保護期間を過ぎている、あるいはそもそも保護されていなかったパブリックドメインのものであり、著作権の許諾なく、誰でもどのような目的でも利用することができます。CCでは、パブリックドメイン作品の忠実なデジタル複製は、パブリックドメインとすべきであり、新たな著作権や関連する権利を生じさせてはならないと強く主張しています(和訳版はこちら)。同じ文脈で、ライセンスは著作権で保護されているコンテンツに関してのみ使用できるものであるため、パブリックドメイン作品のデジタル複製物を公開する際にCCライセンスを使用することはできません。それらを共有するには、現在、パブリックドメインに置くためのツール(CC0)の利用を推奨しています。

広く実践されているが問題のある「PD BY」

しかしながら、非常に多くの所蔵機関がCC0ではないCCライセンスを使って、パブリックドメイン資料の忠実な複製を公開しています。これは「PD BY」とも呼ばれることがあります。なぜこのようなことが広まったのでしょうか?それは、多くの所蔵機関が、文化遺産を保存、修復、デジタル化、共有しているのが自分たちであることを周知したいと考えているためです。そしてこれらの所蔵機関は利用者にクレジットを表記することを求める手段としてCCライセンスを使用しているのです。一方でCC0は帰属の表示を義務付けていません。私たちが作成した「 Needs Assessment Report: Are the Creative Commons Public Domain Tools Fit-for-Purpose in the Cultural Heritage Sector?」の資料でも、アンケートに回答した所蔵機関の約53%が、利用者にクレジット表記をしてもらう方法を求めていると答えており、素材が再利用・共有される際に所蔵機関がクレジット表記を受ける方法が無いことが、CC0で足りていない主なニーズであることが明らかになっています。

パブリックドメイン資料のより良い共有方法について

多くのコレクションが複雑な歴史的・法的背景を経て所蔵機関の管理下にあることを私たちは認識しています。私たちが先住民の文化遺産をオープンに共有することに関連して述べたように、対象物の著作権の状態は、正当な所有権や管理者を決定することはもってのほか、アクセスや利用の可能性を決定する唯一の方法では決してありません。

Sharing Public Domain Collections CC-BY ?!!? by Brigitte Vézina は “The Scream” をリミックスしたものです。本作品はCC BY 4.0のもとで提供されています。
“The Scream” Edvard Munch (1893), Public Domain, National Museum Oslo

管理している所蔵機関をCCライセンスで参照するのは
得策ではない

私たちは、所蔵機関が自分たちのコレクションからのパブリックドメインのデジタルなオブジェクトが利用される際に、自分たちが言及されること望むことに概ね共感しており、功績を認めるべき内容についてはユーザーはそのことをクレジット表記するべきだと考えます。しかし私たちは、実際にそれを行う手段としてCCライセンスを使用することに、以下の4つの主な理由から強く反対します:

  • 資料の著作権状態が不明確になってしまう
  • 資料へのアクセスや利用条件について利用者に混乱と誤解が生じる
  • ライセンスが無効となり法的強制力がない状況を作り出してしまう
  • CCの帰属表示ガイドラインとライセンス表記では、著作物のタイトル、作者または作成者、ライセンス、および出典(通常はURL)のみの記載を要求しているため、必ずしも所蔵機関の記載につながるとは限らない

所蔵機関は何をすべきか?

2022年、Deborah De Angelis(CC Italy)と渡辺智暁(CC Japan)が率いる CC Open Culture Platform のワーキンググループは、この問題を詳細に調査し「PD BY 」の問題に対処するための技術的、法的、社会的介入に関する提案を作成しました。

そしてワーキンググループの挙げた社会的介入策に触発され、私たちは、オープンライセンスまたはパブリックドメインの資料を利用する人々が資料を提供している所蔵機関に言及することを簡単かつ魅力的にするために、所蔵機関が導入できるシンプルなデザインアイデアを開発しました。Behavioural Insights Team の EASTモデル(「ナッジ」によって行動変容を起こしたり、特定の結果を促したりするためのシンプルなフレームワーク)を使って、適切な場面で所蔵機関が包括的な「典拠ステートメント」を提供するためのいくつかの方法を提案します。これらのユーザー・エクスペリエンスに関するアイデアは、CCライセンスやその他ツールと組み合わせて使用することができます。提案する機能の実装方法に関するHTML/CSSコードを含む技術的なガイドラインは提供しませんが、このリソースが各所蔵機関の技術環境に実装可能なデザインの青写真となることを願っています。

所蔵機関のためのクリエイティブ・コモンズの
ガイドライン

どのような情報を含めるべきか?

適切なステートメントには、以下の情報を含めるべきです:

  • タイトル
  • 著者または作成者
  • ライセンスまたは許諾
  • 所蔵機関
  • 出典

こちらはその例です:

Ocean Coast by Maurice Denis、パブリック・ドメイン・マーク、スウェーデン国立美術館
https://collection.nationalmuseum.se/eMP/eMuseumPlus?service=ExternalInterface&module=collection&objectId=23187

所蔵機関はどのようにユーザーを促すことができるか?

所蔵機関は Behavioral Insights Team の EASTモデルを使って、ユーザーを誘導したり言及を促すことができます:

  • Easy(簡単) – 人々が参照しやすいようにする。
  • Attractive(魅力的) – 人々がやりたくなるようなものにする。
  • Social(社会的) – 行動を社会的価値につなげる。
  • Timely(タイムリー) – 適切なタイミングで情報を提供する。

所蔵機関がEASTモデルを適用するための簡単で戦略的な方法をまとめると以下ようになります:

Easy(簡単)にする方法

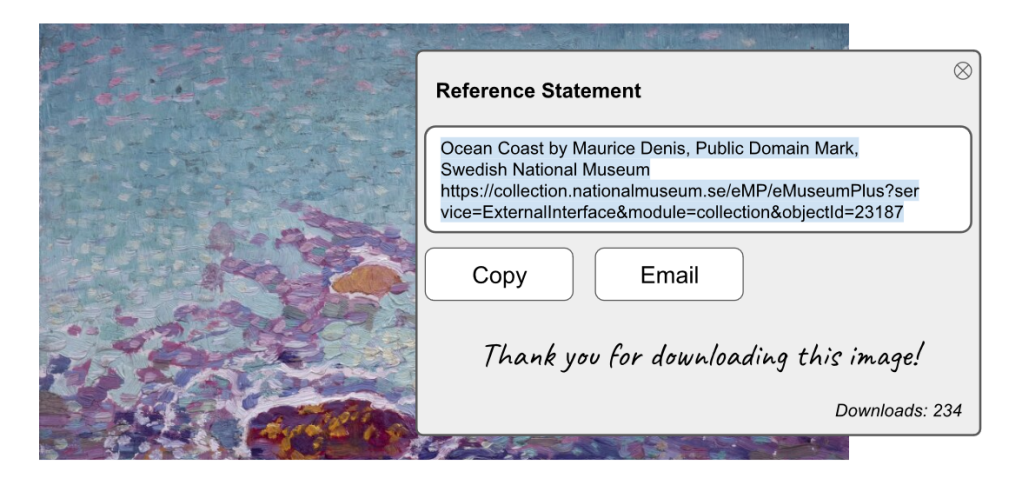
  • ワンクリックで参照先をコピーできるようにする
  • 参考文献のテキストを自動ハイライトする

Attractive(魅力的)にする方法

  • 資料を使ってくれることに感謝の意を述べる
  • ユーザーにとって情報をわかりやすく提供する
  • すべての情報を同時に提供する

Social(社会的)にする方法

  • ダウンロード数の共有
  • 参照情報のコピー回数の共有
  • 適切な参考文献の例を示す
  • ユーザーにソーシャルメディア上で機関のタグ付けを促す
  • 出典を示すことで信頼を築く

Timely(タイムリー)にする方法

  • 資料がダウンロードされたときにポップアップを表示する
  • ダウンロードしたファイルと一緒に参照情報を提供する
  • 参照情報をメールで送信する
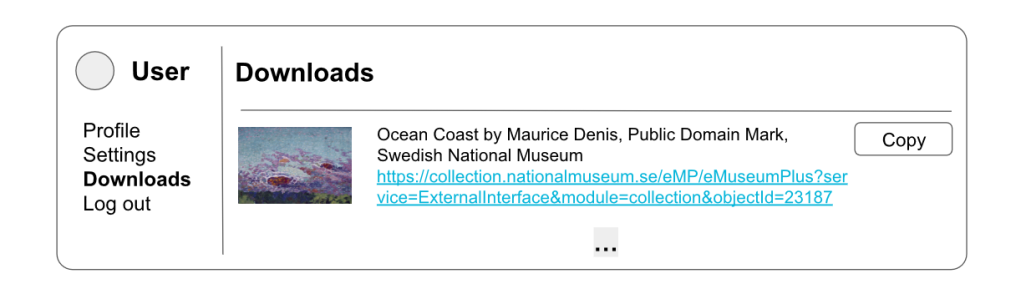
  • ユーザーアカウントを提供し、ユーザーが自身のダウンロード履歴を見られるようにする

実際にナッジの実装例を見てみましょう

このセクションでは、これらの戦略が実際にどのように実装されるか、4つのデザイン案を提示します:

  • コピーボタン
  • 自動ポップアップ
  • テキストファイルをダウンロードするオプション
  • ダウンロード履歴が参照できるユーザープロフィール

典拠ステートメントを簡単にコピーできるボタン

ポップアップで典拠ステートメントを表示

資料と一緒にテキストファイルをダウンロードする

ダウンロード履歴が残るユーザープロフィール

設計のためのデータ整理

このセクションでは、(すべて JSON-LD で動作する)限定的なフレームワークと、典拠ステートメントを含めるのに適した構造を提供するプラットフォームの例を挙げます。

JSON-LD とは?

JSON-LD は軽量のリンクトデータ形式です。リンクトデータとはウェブサイト間で標準ベースの機械可読データのネットワークを構築する方法で、ウェブ上で情報を公開したり利用したりすることを可能にします。JSON-LD は人が読み書きしやすく、すでに成功している JSON フォーマットをベースにしています。JSON-LD は、JSON データをウェブのスケールで相互運用するための方法を提供します。JSON-LD は以下のプラットフォームの例に共通する標準であり、主要な検索エンジンによって推奨され、Internationalized Resource Identifier(RDI)を使用しています。

データフレームワーク

Schema.org の 「CreativeWork」

Schema.org は、インターネット上の構造化データのためのスキーマを作成し、維持し、普及させることをミッションとする共同的なコミュニティによる活動です。スキーマは「タイプ」の集合であり、それぞれが項目の集合に関連付けられ、階層構造になっています。検索エンジンの発見性を高めるための最良の選択肢です。

CreativeWork のタイプには、以下のような数多くの項目があります:

  • 名前(タイトル)
  • 著者および作成者
  • ライセンスと構造化データライセンス
  • 発行者
  • URL
  • 著作権表示とクレジット

これらの項目は、コレクションのデータを標準化された機械可読な方法で構造化することを可能にします。入力データは、別の項目、例えば著作権表示やクレジットの項目を入力するために使用できます。

IIIF の 「requiredStatement」

International Image Interoperability Framework(IIIF)は、コレクション管理のための世界標準であり、世界中の文化遺産機関で広く利用されています。

IIIFの 「requiredStatement」は、資料が表示または利用される際に表示する必要があるテキストです。例えば、著作権や所有権に関する記述、所有機関や公開した機関への言及、そのほか利用者に表示することが重要であると判断されるテキストを何であれ提供することができます。

IIIFの権利表明のための「クックブック」は、ソースコードのガイドラインと実装方法を提供しています。

クリエイティブ・コモンズは所蔵機関に対し、利用者に参照してもらいたいすべての情報を「requiredStatement」に含めることを推奨しています。これには、タイトル、作成者または作者、提供機関名、著作権の状態、使用されているライセンスまたはパブリックドメインツール、出典が含まれます。

ccREL について

The Creative Commons Rights Expression Language(ccREL)は、著作権のライセンス条項や関連情報を機械可読的に表現するためのクリエイティブ・コモンズの標準です。ccRELは、World Wide Web Consortium の Resource Description Framework(RDF)に基づいています。2008年に提案されましたが、それ以来この標準への支持は著しく減少しています。現在は検索エンジンでの発見性向上のために ccREL を使用することは推奨されていません。検索エンジンでの発見性向上のためには Schema.org の 「CreativeWork 」の使用をお勧めします。

共有のためのプラットフォーム

所蔵機関が所蔵するデジタル・オブジェクトを共有するためのプラットフォームは数多く存在します。ここでは、このガイドラインで提示されているデザインアイデアの一部をすでに実装している2つのプラットフォームを紹介します。

Europeana

Europeana は、ヨーロッパの文化遺産コレクションの統合プラットフォームです。公開されている API やその他のツールを使用してデジタルコレクションに関する情報を収集し、ヨーロッパのデジタル化されたコレクションへのアクセスと要覧を世界に提供しています。

このプラットフォームは、ユーザーが資料をダウンロードする際にステートメントを提供します。このステートメントには提供機関からの情報が入力され、Europeana への投稿に最低限必要なメタデータの一部となります。現在は提供機関へのレファレンスが含まれるようになっています。ステートメントは以下のフォーマットに従っています:

 [タイトル] by [作成者] – [年] – [提供者], [国] – [権利に関するステートメント]

ウィキメディア・コモンズ

ウィキメディア・コモンズは、ウィキメディアが提供する画像、音声、動画を含むメディアファイルのコレクションです。アップロード者が資料のメタデータに帰属表示情報を追加した場合、その情報が利用者に対して表示されます。帰属表示に関する情報はメタデータ情報に書き込むことができ、資料のタイトル、作成者、出版機関、著作権ライセンスまたはパブリックドメインツールの情報を入力することができます。これは 「Other fields = {{Credit line}}」のセクションに含めるのがベストです。

追加のサポート

これらのデザインのいずれかを実装する予定はありますか?このガイドラインを発展・改善させる方法(特に技術的な面で)についてご意見はありますか?この資料を他の言語で提供したいですか?

その場合は:

謝辞

このガイドラインは、オープン・カルチャー・コーディネーターの Connor Benedict とクリエイティブ・コモンズの政策・オープン・カルチャー担当ディレクターの Brigitte Vézina によって作成されました。また本ガイドラインの作成にあたって、 Deborah De Angelis (CCイタリア)と渡辺智暁(CCジャパン)が率いるオープン・カルチャー・プラットフォームのワーキンググループのメンバーや、他のクリエイティブ・コモンズコミュニティのメンバー、クリエイティブ・コモンズのスタッフからの有益なフィードバックを受けることができましたことを深く感謝します。

画像のクレジット

その他のクレジット

本資料は Creative Commons による “NUDGING USERS TO REFERENCE INSTITUTIONS WHEN USING PUBLIC DOMAIN MATERIALS” を翻訳したものです。

元の資料のライセンス表示:Creative Commons 2024 | Creative Commons Attribution License 4.0 (CC BY 4.0)

本資料はクリエイティブ・コモンズ 表示 4.0 ライセンスの下に提供されています。

翻訳に際して DeepL の出力を参考にしました。

5/21(火) 生成AIと著作権法制度の未来イベント開催のお知らせ

※本イベントのお申込みは終了いたしました。

クリエイティブ・コモンズ・ジャパン(CCJP)では、生成AIと著作権法・制度の未来について議論するイベントを開催いたします。生成AIによって文化とシェアの関係、クリエイターとデジタル技術の関係など、クリエイティブ・コモンズ・ジャパンが議論してきた領域で数々の論点が浮上しています。法律の専門家だけでなくクリエイター、技術者、一般市民、法学以外の政策研究者など様々な方の意見も踏まえて議論することの重要性もしばしば指摘されるところです。
そこで本イベントでは、デジタル技術や創作活動、文化におけるシェアの役割、著作権法や制度の未来について考えたい方の幅広いご参加を歓迎します。また、今後の幅広い議論に資するような中長期的な課題や問いを議論することを目指したいと思います。

【開催概要】
「生成AIから考える著作権法・制度の中長期課題」

主催:クリエイティブ・コモンズ・ジャパン
後援:国際大学グローバル・コミュニケーション・センター(GLOCOM)
日時:5月21日(火)18:30-20:00
参加料:無料。(事後開催の懇親会は有料)
登壇者:
・奥邨弘司(慶應義塾大学大学院法務研究科 教授)
・中川譲(イラストレーター、宝塚大学 特任教授)
・増田雅史(弁護士、森・濱田松本法律事務所 パートナー)*
・渡辺智暁(国際大学GLOCOM 主幹研究員/教授/研究部長)(モデレーター兼担)*
(*印はCCJPメンバー)

開催形式:ハイブリッド形式
(オンラインはWebEx、オフラインは港区六本木にある国際大学GLOCOM)
お申し込み:オンラインフォームより事前登録をお願いします。
※本イベントのお申込みは終了いたしました。

お問合せ・ご連絡先:
お申し込み期限後のキャンセルなどのご連絡は info at creativecommons.jp までメールでのご連絡をお願いします。( at は@マークに変換してください)

TAROC オープンカルチャーの推奨に向けて

TAROCとは、”Towards a Recommendation on Open Culture”の略語で、「オープンカルチャーに関する勧告に向けて」を意味します。TAROCは、クリエイティブ·コモンズが主導するコミュニティ・イニシアチブ(共同体構想)で、オープン文化の価値、目的、メカニズムを目的とする、積極的で肯定的で影響力のある国際的な勧告文書の作成を支援することを目的としています。これにより、より広範な文化および情報政策を活性化および支援する手段として、文化を世界的にオープンに共有することに繋がります。

このTAROCを紹介するWebページが英語、日本語などで公開されていますので、ご覧ください。

英語ページ: TOWARDS A RECOMMENDATION ON OPEN CULTURE
日本語ページ: TAROC オープンカルチャーの推奨に向けて
関連英語ページ: CC CELEBRATES 20 YEARS OF THE UNESCO CONVENTION ON SAFEGUARDING INTANGIBLE HERITAGE

(担当: 前川)

AI学習のためのプレファレンス・シグナルの可能性を探る

Catherine Stihler
2023年8月31日

作品をオープンに共有したい人々に、より多くの選択肢を提供することがクリエイティブ・コモンズ(CC)設立の動機の一つでした。様々なステークホルダーとの関わりを通して、私たちは彼らが直面する、著作権にまつわる「全面禁止か無制限か」な選択肢に対する不満を耳にしました。彼らは人々に対して、一部の用途では作品を共有したり再利用できるようにし、また一部の用途では利用を制限できることを希望していました。また、アーティスト、技術開発者、アーキビスト、研究者など、クリエイティブな資料を明確で理解しやすい許諾で再利用したいと望む人々を支援することもCCライセンスを作成する動機でした。

“Choices” by Derek Bruff。一部切り抜き。もとのライセンスは CC BY-NC 2.0。

そして何より、他の団体との交流によって明らかになったのは、人々が共有に意欲的であるのは、単に個人の利益のためではなく、むしろ社会的な利益を感じているからだということでした。多くの人々は、人々がアクセスし、それをもとに創作することのできる知識と創造性の集合体、つまりコモンズを支援し、拡大することを望んでいたのです。創造性は豊かなコモンズに依存しており、選択肢を広げることはこれを達成するための手段のひとつでした。

生成系の人工知能(AI*)に関する私達のコミュニティの協議でも類似するテーマが浮上しました。もちろん、2023年の社会におけるAIとテクノロジーは2002年のものとは異なります。しかし、作品群がAIの学習を含むあらゆる用途にオープンであるか、あるいは完全にクローズドであるかというオール・オア・ナッシングのシステムの課題は共通しています。創造性、コラボレーション、コモンズを支援するかたちで作品の再利用を実現したいという願いも当時と同様です。

頻繁に提起された選択肢のひとつは、プレファレンス・シグナリングでした。これは、ライセンスによって強制することはできないものの、クリエイターの希望を示すものとして、一部の用途についてのお願いをする方法です。私たちは、これが重要な検討すべき分野であることを理解しています。プレファレンス・シグナルを考える場合、豊かなコモンズを支援するための包括的なアプローチの一部であること(単に人々が既存の作品をもとに創作する特定の方法を制限するのではないこと)をどのように保証するかや、そのアプローチがオープンライセンシングの意図と両立できるかどうかなど、多くの難しい問題が出てきます。しかし同時に、プレファレンス・シグナリングがより良い共有のあり方を助けるポテンシャルを持っていると考えています。

私たちが学んだこと:幅広いステークホルダーがプレファレンス・シグナルに関心を持っている

生成AIについての私達のコミュニティとの協議に関する最近の投稿で、生成AIに関するコミュニティの幅広い意見を浮き彫りにしました。

生成AIを使って新しい作品を創作している人もいれば、創作、共有、稼ぐ能力を妨げると考え、明確な許諾なしに自身の作品がAIの学習に利用される現在の方法に異議を唱える人もいます。

自身の作品が生成AIの学習に利用されることに関して、多くのアーティストやコンテンツ制作者が、自身の希望をより明確に意思表示する方法を望んでいますが、その希望の内容は様々です。「全面禁止」ことと「無制限か」ことの両極の間には、生成AIの具体的な使われ方に基づくグラデーションがありました。例えば、生成AIが以下のどの用途で使用されるかによって異なっていました。

  • 新しい創作物を編集するため(Photoshop や他の編集プログラムを使って画像を加工するのと同様なもの)
  • 学習に利用された作品と同じカテゴリのコンテンツを作成するため(画像を使って新しい画像を生成するといったもの)
  • 特定の人物を模倣したり、その人物の作品を置き換えるため
  • 特定の人物を模倣したり、その人物の作品を置き換えたりして(非商業的なオマージュやパロディを行うのとは対照的に)商業的にそのアーティストになりすますため

また、(例えば研究者、非営利団体、企業など)誰がAIを作成し、誰が使用するかによっても見解は異なりました。

AIシステムの技術開発者やユーザーの多くも、クリエイターの意思を尊重するためのより良い方法を見つけることに関心を寄せていました。簡単に言うと、AIの学習に関してのクリエイターの意思表示を明確に把握することができれば、彼らはそれに快く従うとのことでした。彼らは要件が大きくなりすぎることに懸念を示していましたが、この問題は「全面禁止か無制限か」ではありませんでした。

プレファレンス・シグナル:豊かなコモンズとの複雑な関係

より良いプレファレンス・シグナルに対する広い関心はありましたが、それをどのように実践するかについての明確なコンセンサスはありませんでした。実際、これらの意思表示がコモンズにどのような影響を与え得るかについては、多少の課題と不確かさがあります。

例えば、生成AIがウェブでの出版にどのように影響を与えるかについての言及がありました。AIの学習に関する懸念はある人にとっては、今後作品をウェブ上で公開しない選択肢を取ることを意味していました。同様に、オープンライセンスで公開されたコンテンツや公益的な取り組みにどのような影響を与えるかを特に懸念する人もいました。もし人々が ChatGPT を使うことで、ウィキペディアを訪れることなくウィキペディアから得られた回答にアクセスすることができるのなら、ウィキペディアの情報コモンズは持続可能であり続けられるでしょうか?

この観点からすると、プレファレンス・シグナルの導入は、他の方法では共有されなかったかもしれない資料の共有を維持・支援すると考えられ、これらの緊張を収める新しい方法を可能にします。

一方、プレファレンス・シグナルがこのような利用を制限するためだけに広く展開されるのであれば、コモンズにとっては損失になりかねません。なぜならこれらの意思表示が表現を過剰に制限するような形で使われる可能性があるからです。例えば、特定のアーティストやジャンルにインスパイアされたアートを創作することを制限したり、人間の知識の重要な領域を学習したAIシステムから回答を得ることを制限するといったものです。

さらに、CCライセンスは、オープンソースソフトウェアライセンスと同じように、利用に関する制限に抵抗してきました。このような制限はしばしばあまりに広範であるため、望ましくない利用だけではなく、多くの価値ある、コモンズ的な利用をも断ち切ってしまいます。多くの場合、望ましくない利用の可能性と、良い利用によって開かれる機会とはトレードオフの関係にあります。もしCCがこのような制限を支持するのであれば、私たちが望むのは「コモンズ・ファースト」のアプローチであることを明確にする必要があります。

この緊張関係は簡単に解決できるものではありません。むしろ、プレファレンス・シグナルだけではコモンズを維持するのに十分ではなく、数多く存在する選択肢のうちの一つとして検討されるべきものであることを示唆しています。

既に存在しているプレファレンス・シグナルの取り組み

この記事において、ここまではプレファレンス・シグナルについての抽象的な話をしてきましたが、このテーマについてはすでに多くの取り組みが進行中であることに言及する必要があります。

例えば Spawning.ai は、アーティストが自身の作品が人気のある LAION-5B データセットに含まれているかどうかを調べ、データセットから除外するかどうかを選択するのに役立つツールに取り組んでおり、さらに、AI開発者がそのリストとの連携を可能とするAPIを作成しました。StabilityAI はすでに、アーティストの明示的なオプトインとオプトアウトを尊重しながら、これらの意思表示を、ツールの学習に使用したデータに組み込み始めています。人気サイト Hugging Face でホストされているデータセットのうち適合するものについては、Spawning の API を利用したデータレポートを表示するようになっています。データレポートは、オプトアウトされたデータとそれを除外する方法を学習済みモデルを作る人に知らせます。Spawning はまた、ウェブでコンテンツを公開している人々のために、robots.txt と似た、商業的なAIの学習のためのサイトのコンテンツ使用に関する制限や許可を示す「ai.txt」 ファイルのジェネレータにも取り組んできました。

同様の取り組みは他にも数多くあります。例えば、ワールド・ワイド・ウェブ・コンソーシアム(W3C)内の出版社からなるグループは、ウェブサイトがテキストやデータのマイニングに関して意思表示できるようにするための標準に取り組んでいます。EUの著作権法では、機械が読み取り可能なフォーマットを通じて、人々がテキストやデータマイニングからオプトアウトすることを明示的に認めており、この標準がその目的を果たすという考えです。Adobe は、自社が提供するいくつかのツールで生成された作品のために「Do Not Train」メタデータタグを作成し、Google は robots.txt と同様のアプローチを構築することを発表し、OpenAI は、将来のバージョンのGPTのためのクロールからサイトを除外する手段を提供しています。

プレファレンス・シグナル導入の課題と疑問

こうした取り組みはまだ比較的初期段階にあり、多くの課題や疑問があります。いくつか挙げてみましょう。

  • 使いやすさと導入のしやすさ:プレファレンス・シグナルが効果的であるためには、コンテンツ制作者や後続のユーザーにとって利用しやすいものでなければならなりません。使いやすく、スケーラブルで、さまざまなタイプの作品や用途、ユーザーに対応できる方法とはどのようなものでしょうか?
  • 選択肢を認証する:ある意思表示が、適切な当事者によって設定されたものであることをどのように検証し、信頼するのが最善なのでしょうか?関連して、誰がプリファレンスを設定することができるべきなのでしょうか?それは作品の権利者、作品を創作したアーティスト、あるいはその両者なのでしょうか?
  • アーティストのためのきめ細かな選択肢:これまでのところ、ほとんどの取り組みは、AIの学習のための利用を人々がオプトアウトできるようにすることに焦点が当てられています。しかし、上述したように、人々には様々な好みがあり、プレファレンス・シグナルは、人々が自分の作品が利用されることに問題がないことの意思表示をする手段でもあるべきです。人々がきめ細かな好みを表明できるようにしつつ、煩雑になりすぎないようにバランスを取るにはどうすれば良いでしょうか?
  • 作品とユーザーのタイプに応じた調整と柔軟性:この記事ではアーティストに焦点を当てましたが、もちろんクリエイターや作品の種類は多種多様です。例えば、プレファレンス・シグナルは科学研究にどのように対応できるでしょうか?ウェブサイトのインデックス作成という文脈では、営利目的の検索エンジンは一般的に robots.txt プロトコルに従いますが、アーキビストや文化遺産団体のような機関は、公益的使命を果たすためにクロールを行うことがあります。AIをめぐる同様の規範をどのように整備できるでしょうか?

プレファレンス・シグナルを構築する取り組みが進むのに合わせて、有益な道筋が見えてくることを期待して私たちはこれらを含めた様々な疑問を探求し続けます。さらに、共有とコモンズを支援するために必要なその他のメカニズムについても引き続き探求していきます。CCは、「AIとコモンズ」をテーマとする10月のサミットを含め、このテーマにさらに深く取り組んでいきます。

世界中の様々な人や機関と同じく、CCは生成AIを注視し、この驚くべき新しいツールが提起する多くの複雑な問題を理解しようとしています。私たちは特に、著作権法と生成AIが交わる部分に注目しています。より良い共有のためのCCの戦略は、人間のクリエイターの仕事も尊重しつつ、このテクノロジーの発展をどのようにサポートできるのか?誰にとってもより良いインターネットでAIが運用するにはどうすればいいのか?これらの問題を私たちは、CCチームとゲストによる一連のブログ記事で探求しています。そこでは、AIのインプット(学習データ)、AIのアウトプット(AIツールによって作成された作品)、そして人々がAIを使用する方法に関する懸念事項を取り上げています。詳細については生成AIに関する概要を読むか、AIに関するすべての記事をご覧ください。

* 注:「人工知能」や「AI」は、現在、機械学習や大規模な言語モデル(LLM)を含む複雑な技術や実践の分野を指す略語として使用しています。「AI」という略語の使用は便利ではありますが、これは理想的ではありません。なぜなら、AIは実際には(AIが人間によって作られ使用されるという意味で)「人工的」ではなく、さらに(少なくとも我々が人間の知性について考えるような意味で)「知的」でもないからです。


このブログ投稿は Catherine Stihler による “Exploring Preference Signals for AI Training” を一部省略し翻訳したものです。

また、翻訳に際しては DeepL の出力を参考にしました。

(担当:豊倉)

CCJP年次報告書(2022年度分)のお知らせ

クリエイティブ・コモンズ・ジャパン(CCJP)では、7月30日に最近一年ほどのCCJPやグローバルのCCの活動を紹介すると共に、生成系AIとオープンライセンスなどオープン化に関連した動向を紹介・議論するイベントを開催しました。このイベントの主なスライド資料を元に、CCJP年次報告書として公表させていただきます。末尾にはCCJPの母体であるNPO法人コモンスフィアの会計報告なども記載しています。ぜひ一度ご覧いただけたら幸いです。
報告書: オンラインスライド版 (Google Slides), PDF版

CCJP年次報告会2023にお申し込み頂いた皆様

Web参加でお申し込み頂いた方には当日視聴用URLご案内のメールをお送りしております。(7月27日18:00現在)

もしメールが届かないなどの不具合があればinfo at creativecommons.jp ( at は@マークに変換してください)までご連絡ください。

当日リアル参加でお申し込み頂いた方は、直接会場までお越しください。

皆様のご参加、心よりお待ちしております。

*報告会参加申し込みは締め切りました。(7月30日11:25AM)

7/30(日) CCJP年次報告会2023 開催のお知らせ

クリエイティブ・コモンズ・ジャパン(CCJP)では、最近一年ほどのCCJPやグローバルのCCの活動を紹介すると共に、生成系AIとオープンライセンスなどオープン化に関連した動向を紹介・議論するイベントを開催します。

私たちCCJPが普段どのような活動をしており、グローバルのCCではどのような動きがあるかをお伝えするとともに、最近のオープン化のトピックとしていわゆる生成系AIにおけるオープンライセンスやオープン化についてとりあげます。

CCやオープン化にまつわる情報共有と意見交換の機会としたいと思っていますので、CCの活動に興味をお持ちの方々はもちろん、著作権、オープンライセンス、AIとオープン化などにご関心のある方も、ぜひお気軽にご参加ください。

【開催概要】
「CCJP年次報告会2023」
日時:7月30日 (日) 16:00-18:00
参加料:メインプログラムは無料。懇親会のみ有料。
開催形式:ハイブリッド形式
(オンラインはWebEx、オフラインは港区六本木にある国際大学GLOCOM)
お申し込み:オンラインフォームより事前登録をお願いします。*申し込みは締め切りました。

【プログラム(暫定版)】
※当日までに変更になる可能性があることをご了承ください。
16:00-16:30 最近のCCJPの活動報告(事務局 豊倉幹人、理事長 渡辺智暁)

(ライセンス執行に関する文書・ブログエントリ翻訳)
(NFT、オープンアクセスに関するFAQs、CCPL20周年記念イベント)

16:30-17:00 グローバル CC 活動紹介(CCJP事務局 前川充)

(Annual Report、CC Summit 2022)

17:00-17:15 休憩
17:15-17:45 生成系AIとオープン化(事務局 豊倉幹人、理事 水野祐、理事長 渡辺智暁)
17:45-18:00 質疑応答
18:30-    懇親会(会場近傍の飲食店にて)

お問合せ・ご連絡先:
お申し込み期限後のキャンセルなどのご連絡は info at creativecommons.jp までメールでのご連絡をお願いします。( at は@マークに変換してください)